Aktualność tekstów o AI: data „stan wiedzy” i skrypt, który sprawdza fakty
Słowniczek przy akapicie, linia „Stan wiedzy” i skrypt, który co tydzień porównuje liczby z tekstów ze źródłami. Tak utrzymuję 61 tekstów na portalu.
 Przemysław Filipiaktwórca delta240mvt
W piątek skrypt, który napisałem kilka godzin wcześniej, zwrócił listę rozbieżności. Jedna z nich: w trzech tekstach na portalu stał najmocniejszy model Anthropic z ceną 10 i 50 dolarów za milion tokenów. Model miał już nowszą wersję, a cena spadła do 8 i 40. Przykład z jednego z tekstów, koszt tysiąca wywołań, liczył 45 dolarów. Dziś to 36.
Nikt mi tego nie zgłosił. Teksty miały trzy tygodnie. W tym czasie zmieniła się wersja, cena, nazwa trybu w jednym narzędziu i zapis jednej reguły w dokumentacji. O tym jest ten wpis: o tym, jak traktuję teksty na delta240mvt.com jak kod, który trzeba utrzymywać, a nie jak coś, co się raz publikuje i zostawia.
Dwa problemy, które ma każdy tekst o AI
Pierwszy problem to słowa. Piszę dla ludzi, którzy chcą zacząć budować z AI, a nie dla programistów. A mimo to w zwykłym tekście o MCP pada host, klient, serwer, JSON-RPC, specyfikacja. Każde z tych słów to moment, w którym ktoś przestaje czytać. Albo otwiera drugą kartę z wyszukiwarką i już nie wraca.
Drugi problem to fakty. Ceny modeli, numery wersji, nazwy trybów, limity planów. W świecie AI to wszystko zmienia się co kilka tygodni. Tekst, który był prawdziwy w październiku, w listopadzie po cichu kłamie. I to jest gorsze niż literówka, bo czytelnik na tej liczbie podejmuje decyzję.
Te dwa problemy łączą się ze sobą. Prosty język buduje zaufanie: ktoś pierwszy raz rozumie, czym jest MCP, i wraca po kolejny tekst. Jedna zła cena to zaufanie burzy szybciej, niż słowniczek je zbudował. Więc nie da się zrobić tylko jednej połowy.
Na oba problemy zrobiłem w tym tygodniu jedno: system. Nie „przeczytam to jeszcze raz”, tylko konkretne pola, reguły i skrypt.
Słowniczek stoi przy akapicie, nie na końcu
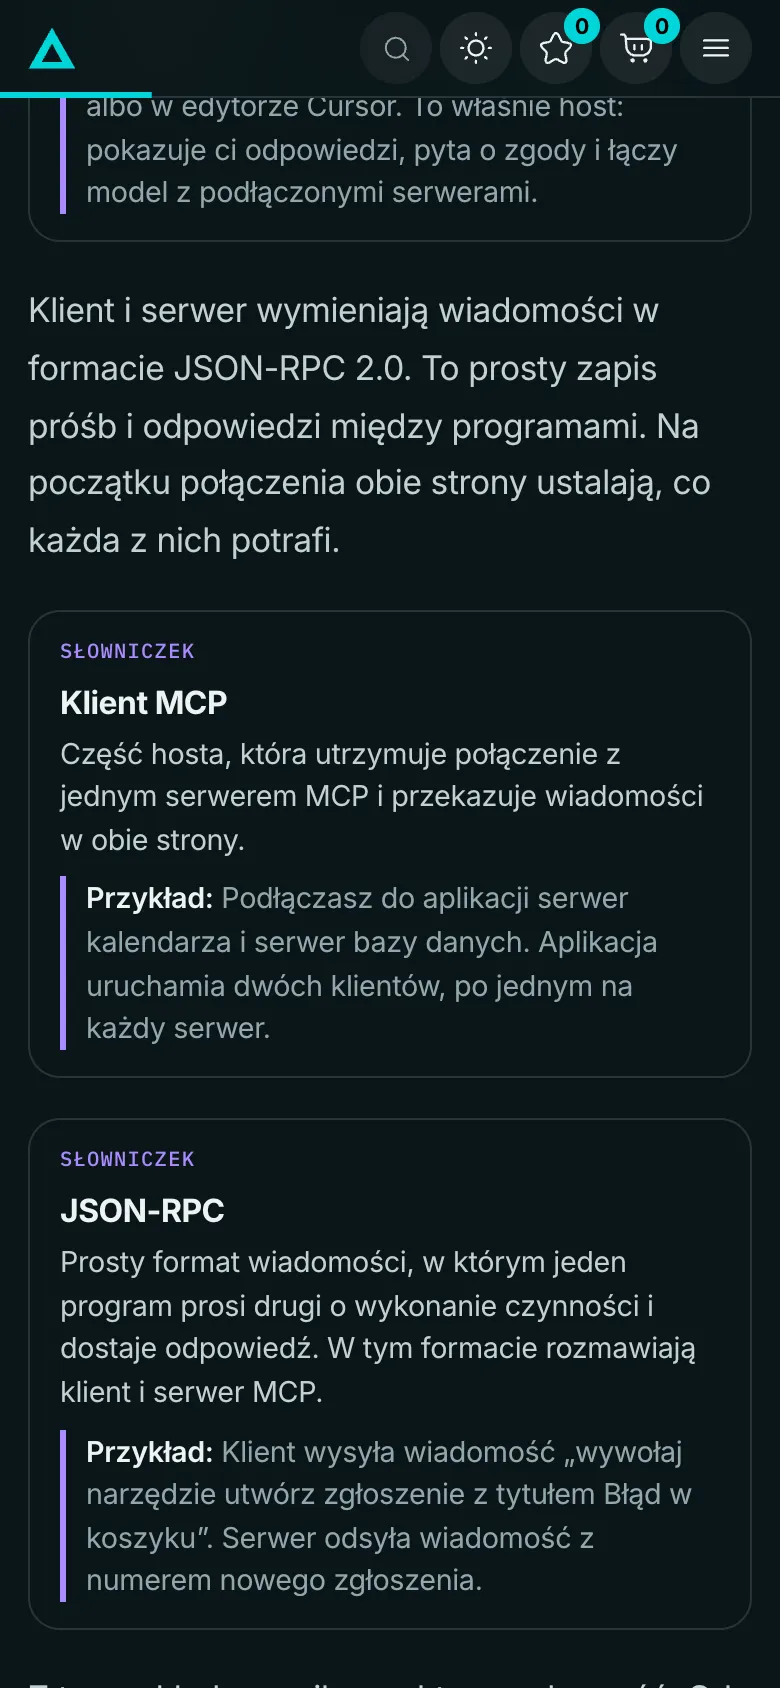
Wcześniej trudne słowa tłumaczyłem w tekście, w nawiasie, albo wcale. Teraz każdy tekst ma słowniczek, ale nie na dole strony. Każde hasło stoi przy akapicie, w którym słowo pada pierwszy raz. Na szerokim ekranie na prawym marginesie, obok tekstu. Na telefonie w ramce, zaraz pod akapitem.
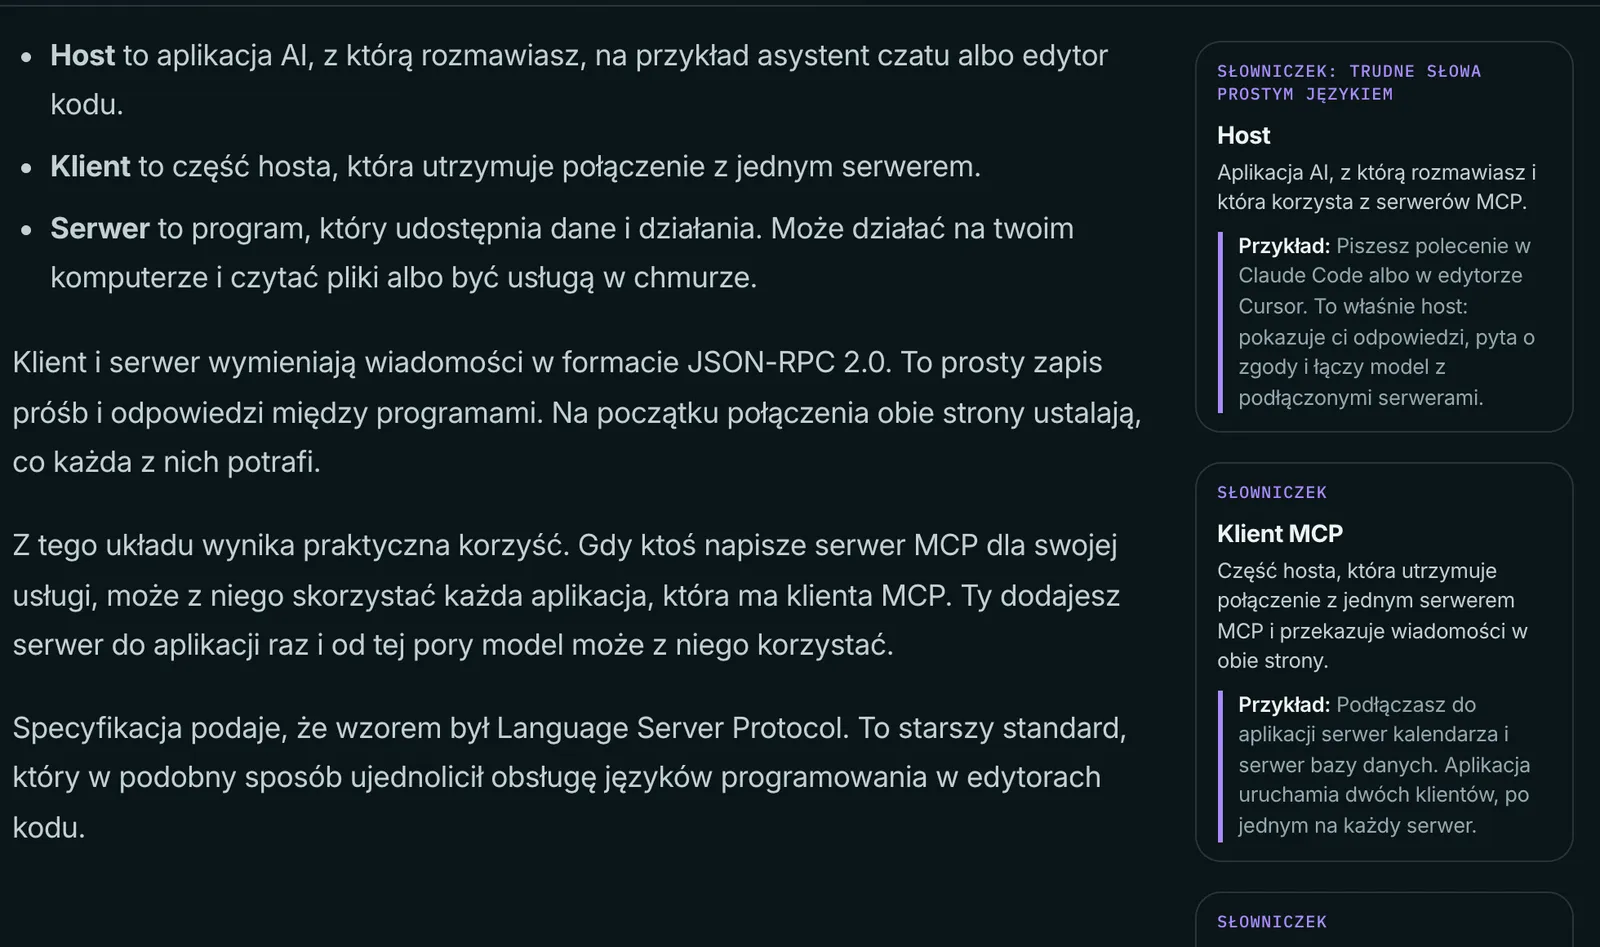
Każde hasło ma trzy części. Termin. Jedno, dwa zdania wyjaśnienia bez żargonu, tak żeby zrozumiał je ktoś, kto nigdy nie programował. I przykład z życia, który zaczyna się od „Jak…”. To trzecie było najważniejsze. Definicja mówi, czym coś jest. Przykład mówi, jak to poczuć.
Zasada dla przykładu: konkretna sytuacja z codzienności. Kantor, szatnia, kuchnia, przychodnia. Nie kolejna definicja innymi słowami. Jeśli przykład wymaga trudnego słowa, to nie jest przykład.
Różnicę widać najlepiej na jednym haśle. Słabo: „tokeny to jednostki, na które model dzieli tekst wejściowy”. Wszystko prawda, ale po tym zdaniu wiesz tyle samo co przed. Lepiej: „kawałki tekstu, za które płacisz”, a do tego przykład z taksówką liczoną za przejechane metry. Od razu rozumiesz, czemu dłuższa rozmowa z modelem kosztuje więcej.
Tego chcę przy każdym haśle: żeby czytelnik po dwóch zdaniach wiedział, co z tym słowem zrobić.
Każde hasło ma też wersję angielską, bo portal ma dwie wersje językowe. Nie tłumaczę przykładu słowo w słowo. Szukam sytuacji, która zadziała w danym języku.
Tego samego piątku przeszedłem tak przez wszystko, co było na portalu od początku. Liczby z commitów:
| Co | Ile tekstów |
|---|---|
| Artykuły ze słowniczkiem i prostszym językiem | 48 (w 10 paczkach) |
| Eseje ze słowniczkiem | 6 |
| Lekcje „pierwszy tydzień”, napisane od nowa | 7 |
| Teksty sprawdzone ze źródłami 13 listopada | 47 |
| Adresy źródeł pobrane do porównania | 275 |
Siedem lekcji napisałem od nowa, a nie tylko uzupełniłem. Stara wersja zakładała, że czytelnik umie już otworzyć terminal. Nowa zaczyna się od instalacji aplikacji Claude albo ChatGPT i od pracy z agentem w karcie Code albo w Codexie. Każda lekcja ma polecenia do wklejenia, jedno zadanie na dziś, sekcję „jeśli coś nie działa” i dwie animacje w treści, które pokazują krok, zamiast go opisywać. Kroki i nazwy trybów sprawdziłem w dokumentacji obu firm tego samego dnia. Bo lekcja, w której przycisk nazywa się inaczej niż na ekranie, kończy się na pierwszym kroku.
Przy okazji to samo przeniosłem na tę stronę. Ten wpis też ma słowniczek, tak jak wcześniejsze, np. o modelach 3D z kodu w Blenderze i Pythonie, a linter nie przepuści wpisu, który ma mniej niż trzy hasła albo hasło, którego nie ma w tekście.
Jak pokazać, z kiedy jest wiedza w tekście?
Datą ostatniego sprawdzenia, widoczną pod tytułem. To druga połowa systemu: każdy tekst ma teraz pole z datą ostatniego sprawdzenia i linię „Stan na…” pod tytułem, obok daty publikacji i aktualizacji. Czytelnik od razu widzi, z kiedy jest wiedza.
Ale data sama nic nie daje, jeśli nikt jej nie odświeża. Więc napisałem skrypt. Bierze listę źródeł każdego tekstu i pobiera ich dzisiejszą treść. Z tekstu wyciąga liczby, kwoty, daty, numery wersji, nazwy modeli i nazwy poleceń. Potem sprawdza, czy każda z tych rzeczy stoi dziś w źródłach tego tekstu. Jeśli nie stoi, trafia do raportu.
Pierwszy przebieg: 275 adresów, 262 dało się porównać automatem, 13 trzeba było otworzyć ręcznie. Strony rysowane skryptem, pliki PDF, strony, które blokują automaty. Z tego wyszło sześć poprawek w tekstach. Nowa wersja modelu z niższą ceną. Zdanie „flagowe modele dwóch firm kosztują tyle samo”, które przestało być prawdą. Nowa nazwa domyślnego trybu w jednym narzędziu. Dwa zdania, którym brakowało źródła.
Osobno sprawdzam same linki. Źródło, które przestało się otwierać, jest tak samo złe jak zmieniona cena, bo czytelnik nie ma jak sprawdzić, skąd wziąłem liczbę. Ostatni przebieg: 364 adresy, 362 otwierają się poprawnie, 2 odrzucają automaty, ale w przeglądarce działają. Te dwa mam zapisane, żeby nie sprawdzać ich za każdym razem od zera.
Czy skrypt może sam poprawiać fakty w tekstach?
U mnie nie. Skrypt niczego nie poprawia, tylko szuka, a decyzję podejmuję ja. Raz w tygodniu, w poniedziałek o 6:00, zadanie w aplikacji Claude na moim komputerze uruchamia porównanie i kończy się raportem. Bez commitów, bez wdrożenia, bez pisania w treści. Czemu tak?
Bo skrypt nie rozumie kontekstu. Liczba może nadal stać na stronie źródła, ale przy innym modelu. Wtedy skrypt powie „ok”, a tekst kłamie. Dlatego ceny i nazwy modeli porównuję osobno, ręcznie. I odwrotnie: skrypt zgłasza moje własne przykłady, których w żadnym źródle nie ma i mieć nie będzie. Takie pozycje po sprawdzeniu trafiają na listę przyjętych i więcej nie wracają w raporcie. Bez tej listy po trzech tygodniach raport byłby długi, pełen fałszywych alarmów i przestałbym go czytać.
I jedna reguła, której pilnuję najbardziej: datę „Stan na…” zmieniam tylko w tekstach, które naprawdę sprawdziłem tego dnia. Inaczej data staje się dekoracją. A cały sens jest w tym, że jej można wierzyć.
Dobry przykład z tego przebiegu: zdanie, że flagowe modele dwóch firm kosztują tyle samo. Skrypt nie miał do czego się przyczepić, bo obie liczby, które stały w tekście, nadal stały w źródłach. Tylko że jedna z nich była już ceną starszej wersji. Ceny są dziś zbliżone, nie równe. Takie rzeczy łapie dopiero człowiek, który patrzy na liczbę razem z nazwą obok.
Ile to zajmuje? Pierwszy przebieg był długi, bo dotyczył wszystkich tekstów naraz i zbudowałem przy nim listę przyjętych pozycji. Kolejne mają być krótkie: raport w poniedziałek rano, kilka pozycji do otwarcia, poprawka, wdrożenie jednym poleceniem. Wolę kwadrans co tydzień niż jeden wielki przegląd raz na pół roku, po którym połowa tekstów jest do napisania od nowa.
Czego to nie łapie? Zdań bez liczby i bez nazwy. Ocen, porad, „to podejście jest lepsze”. To dalej sprawdzam głową. Ale liczby i wersje to większość tego, co się starzeje, i to robi teraz automat.
Co z tego biorę
Myślałem o tekstach jak o czymś skończonym. Publikuję, idę dalej. W AI to nie działa. Tekst ma swoje zależności, tak jak kod: ceny, wersje, dokumentacje. Kiedy zależność się zmienia, tekst trzeba „przebudować”. Różnica jest taka, że kod przy złej zależności się wysypuje, a tekst dalej wygląda dobrze.
Jeśli piszesz o narzędziach, zrób na dziś jedną rzecz: dopisz do każdego tekstu datę „stan wiedzy” i listę źródeł, z których bierzesz liczby. Bez tego nie zbudujesz żadnej automatycznej kontroli, bo nie będzie z czym porównać. Słowniczek możesz dodać potem. Datę i źródła dodaj teraz. Więcej o pracy nad tekstami z AI jest na portalu, w hubie o treściach tworzonych z AI.
A tu, na tej stronie, zasada jest ta sama: każdy wpis ma słowniczek przy akapicie. W drugim dzisiejszym wpisie, o tym, jak piszę hook, okładkę i kartę końcową rolki, słowniczek stoi przy hooku i okładkach.
Pracuję z ludźmi 1:1 pod marką delta240mvt. Na Twoim projekcie, od pierwszego kroku.
Zobacz ofertę ↗